قابلیت اعتماد AI Agent: خطای انباشته، بازیابی و معیار توقف
یک AI Agent ممکن است در یک نمایش کوتاه درخشان باشد و در یک کار چندساعته، آرام و بیسروصدا از هدف منحرف شود. خطای اصلی گاهی انتخاب ابزار غلط نیست؛ ساختن یک فرض غلط، نگهداشتن آن در حافظه و اعلام موفقیت بر مبنای همان فرض است. قابلیت اعتماد عامل هوش مصنوعی را باید روی مسیر، بازیابی و شواهد پایان کار سنجید، نه روی کیفیت آخرین جملهٔ آن.
۱. قبل از ساختن حلقه، قرارداد موفقیت را بنویسید
«یک عامل بساز که مهاجرت داده را انجام دهد» specification نیست. موفقیت باید به گزارههایی دربارهٔ جهان تبدیل شود: تعداد رکوردهای موردانتظار منتقل شده، شناسهها حفظ شده، محدودیتهای مقصد برقرار است، تغییرهای همزمان گم نشده و مسیر بازگشت مشخص است. بعضی شرطها دربارهٔ حالت نهاییاند؛ بعضی دربارهٔ تاریخچه. حذف موقت داده و بازسازی بعدی شاید حالت نهایی را درست کند، اما تعهد عدمحذف را نقض کرده باشد.
سه معیار را جدا کنیم: صحت نتیجه، مجازبودن مسیر و درستی گزارش پایان. عاملی که نتیجه را درست کرده ولی بدون مجوز دادهٔ حساس را صادر کرده، موفق نیست. عاملی که امن متوقف شده اما کار را کامل نکرده، ایمن بوده ولی موفقیت وظیفه نداشته. عاملی که کار نیمهتمام را کامل گزارش میکند، یک failure mode مستقل دارد: پایان کاذب.
در τ-bench، نتیجهٔ اجرای عامل با حالت هدف پایگاه داده مقایسه میشود. خود نویسندگان هم توضیح میدهند که یک نتیجهٔ صحیح لزوماً همهٔ تخلفهای مسیر، مثل اقدام بدون تأیید کاربر، را آشکار نمیکند. همین محدودیت، دلیل خوبی برای جداکردن ارزیابی حالت نهایی از ارزیابی اختیار و مسیر است.[۱]
قرارداد باید پیش از تولید پاسخ قفل شود. اگر خود عامل، بعد از دیدن نتیجه، معیار موفقیت را بازنویسی کند، مسئلهٔ ارزیابی را به مسئلهٔ توجیه تبدیل کردهایم. میتواند پیشنهاد اصلاح معیار بدهد، اما پذیرش آن باید یک تصمیم جدا و قابلردگیری باشد.
۲. خطای انباشته را با احتمال شرطی بنویسیم
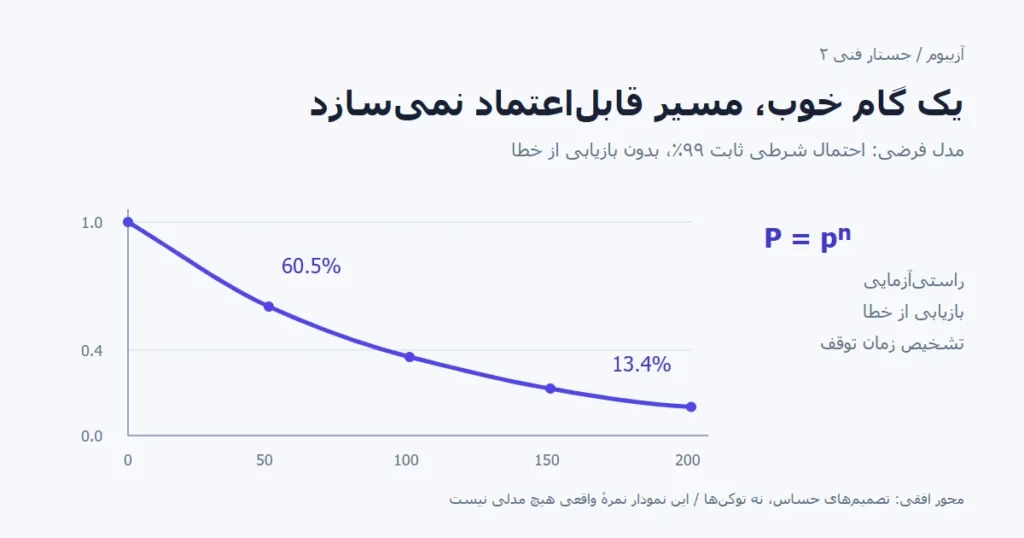
فرض کنیم یک مسیر از n تصمیم حساس تشکیل شده و هیچ خطای مهمی در طول مسیر بازیابی نمیشود. رخداد Sᵢ را «تصمیم i با توجه به وضعیت واقعی، معتبر است» تعریف کنیم. احتمال موفقیت کامل از قاعدهٔ زنجیرهای به دست میآید:
P(S₁ ∩ … ∩ Sₙ)
  = Πᵢ P(Sᵢ | S₁ ∩ … ∩ Sᵢ₋₁)
این رابطه به استقلال تصمیمها نیاز ندارد. عدد هر مرحله، احتمال موفقیت مشروط به درستماندن تمام پیشوند است. فقط اگر همهٔ این احتمالهای شرطی را برابر p فرض کنیم، رابطه به pⁿ تبدیل میشود. استفاده از «دقت متوسط ابزار» بهجای این احتمال شرطی، معمولاً توجیه نشده است.
یک محاسبهٔ فرضی: با p = 0.99، بقای ۵۰ تصمیم حدود ۶۰٫۵٪ و بقای ۲۰۰ تصمیم حدود ۱۳٫۴٪ است. اینها نمرهٔ هیچ مدل واقعی نیستند. نشان میدهند که حتی یک احتمال شرطی بالا، در مسیر بلندِ بدون بازیابی، تضمین قوی نمیسازد. معکوس رابطه هم آموزنده است: برای موفقیت ۹۵٪ در ۱۰۰ تصمیم همریسک، باید احتمال شرطی هر تصمیم حدود ۹۹٫۹۴۹٪ باشد.
0.99^50  ≈ 0.6050
0.99^200 ≈ 0.1340
p ≥ 0.95^(1/100) ≈ 0.999487
اما «تصمیم حساس» با «توکن» یا «فراخوانی ابزار» یکی نیست. ده فراخوانی فقطخواندنی شاید یک تصمیم معنایی بسازند؛ یک فراخوانی نوشتن میتواند چندین تعهد ایجاد کند. باید واحد خطر را بر اساس احتمال نقض قرارداد تعریف کرد. کوتاهکردن مصنوعی trace، اگر همان خطر را داخل یک ابزار بزرگ پنهان کند، قابلیت اعتماد را بهتر نکرده است.
۳. میانگین دقت، هندسهٔ شکست را پنهان میکند
دو سیستم میتوانند دقت تکاجرا یکسان داشته باشند، اما برای استفادهٔ تکراری رفتار متفاوتی نشان دهند. در یک مدل فرضی، نیمی از وظایف برای عامل اول همیشه حلشدنی و نیمی همیشه حلنشدنیاند. عامل دوم برای هر وظیفه در هر اجرای مستقل، با احتمال ۵۰٪ موفق میشود. میانگین موفقیت تکاجرا در هر دو ۵۰٪ است؛ احتمال موفقیت در هر چهار اجرای یک وظیفه برای اولی ۵۰٪ و برای دومی ۶٫۲۵٪ است.
در حالت کلی، اگر احتمال موفقیت وظیفهٔ j برابر pⱼ باشد و اجراها درون همان وظیفه مستقل فرض شوند، ثبات k اجرا به E[pⱼᵏ] مربوط است، نه به (E[pⱼ])ᵏ. تفاوت این دو کمیت را نباید با استقلال مراحل یک اجرا قاطی کرد. یکی ناهمگنی وظایف است؛ دیگری وابستگی مسیر.
τ-bench میان pass@k، موفقشدن حداقل یک اجرا، و pass^k، موفقشدن همهٔ اجراها، تمایز میگذارد. اولی برای جستوجوی راهحل با امکان انتخاب جواب درست مفید است؛ دومی سؤال نزدیکتری به ثبات خدمت میپرسد. فرمول برآورد مقاله نیز این تفاوت را در سطح هر وظیفه نگه میدارد.[۱]
برای عملیات دارای اثر خارجی، «یک بار از پنج بار جواب درست تولید شد» معیار کافی نیست. چهار اجرای دیگر ممکن است ایمیل غلط فرستاده یا تغییر نامجاز داده باشند. افزایش تعداد تلاشها فقط وقتی بیخطر است که تلاشها در محیط بدون اثر انجام شوند و تشخیص پاسخ درست واقعاً در دسترس باشد.
۴. هدف، بیخطابودن نیست؛ بازگشت به حالت معتبر است
مدل بقای قبلی عمداً بازیابی را حذف میکرد. برای فهم بازیابی، مدل سادهٔ دیگری بسازیم: C حالت معتبر و D حالت منحرف است. در هر گام، با احتمال α از C به D میرویم و با احتمال β از D به C برمیگردیم. در این مدل فرضیِ ثابت و مارکوفی، ماتریس گذار چنین است:
       C       D
C   1 - α      α
D     β      1 - β

π(C) = β / (α + β),   α + β > 0
نسبت پایدار نشان میدهد که بالا بردن نرخ بازیابی میتواند مهم باشد. اما π(C) احتمال موفقیت نهایی وظیفه نیست و هیچ تضمینی دربارهٔ نداشتن تخلف در گذشته نمیدهد. این مدل نه اثر برگشتناپذیر را دارد، نه حالت پایان، نه مشاهدهٔ ناقص. اگر عامل یک پیام محرمانه فرستاده باشد، بازگشت به یک وضعیت داخلی درست آن افشا را پاک نمیکند.
در طراحی واقعی، حداقل حالت «نتیجهٔ خارجی نامعلوم» و «اثر برگشتناپذیر نامجاز» را جدا میکنیم. بازیابی از استدلال غلط با بازیابی از عملیات مالی انجامشده یکی نیست. همچنین نرخ بازیابی باید بر مبنای مدرک بیرونی اندازهگیری شود؛ اگر خود عامل اعلام کند «اشتباه را اصلاح کردم»، هنوز فقط یک ادعا داریم.
این تمایز، طراحی حافظه را عوض میکند. بهجای نگهداشتن تنها یک روایت پیوسته، باید معلوم باشد کدام گزاره فرض است، کدام مشاهده و کدام تأییدشده. بازیابی یعنی ابطال یک فرض و بازسازی تصمیمهای وابسته به آن، نه فقط افزودن جملهٔ «در پاسخ قبلی اشتباه کردم» به تاریخچه.
۵. retry، بدون اطلاعات تازه، میتواند همان شکست را تکثیر کند
اگر احتمال موفقیت هر تلاش مستقل p باشد، احتمال حداقل یک موفقیت در k تلاش برابر 1 − (1 − p)ᵏ است. استقلال و ثابتبودن مسئله شرطهای مهم این محاسبهاند. در عمل ممکن است همهٔ تلاشها همان سند غلط، همان ابهام مجوز یا همان خطای طراحی را ببینند. در آن صورت تغییر seed الزاماً مسیر تازهٔ حل ایجاد نمیکند.
فرض کنیم ۲۰٪ وظایف با نقصی سیستماتیک روبهرو هستند و در همهٔ تلاشها شکست میخورند. در ۸۰٪ باقیمانده، احتمال موفقیت مستقل هر تلاش ۹۰٪ است. موفقیت یک تلاش ۷۲٪ است؛ سه تلاش آن را به حدود ۷۹٫۹۲٪ میرساند، نه ۹۷٫۸٪ که از استقلال نادرست روی میانگین ۷۲٪ به دست میآید. این نمونه هم فرضی است؛ نقش سقف خطای سیستماتیک را نشان میدهد.
P(success in 3 attempts)
  = 0.8 · (1 - 0.1^3)
  = 0.7992

naive estimate = 1 - 0.28^3 ≈ 0.9780
قبل از retry بپرسیم چه چیزی تغییر کرده است: مشاهدهٔ تازه، نسخهٔ اصلاحشدهٔ ورودی، راهبرد متفاوت یا بازخورد قابلاتکا؟ اگر پاسخ «هیچچیز» است، شاید فقط داریم بودجه را روی یک خطای ثابت مصرف میکنیم. برای عملیات اثرگذار باید پرسش دیگری هم اضافه شود: آیا تلاش قبلی واقعاً شکست خورده یا فقط پاسخ آن گم شده است؟ retry در حالت دوم، مسئلهٔ قابلیت اعتماد را به مسئلهٔ اثر تکراری تبدیل میکند.
۶. verifier باید چیزی بداند که تولیدکننده نمیداند
یک مدل دوم، فقط به دلیل دومبودن، داور مستقل نیست. اگر همان داده و همان فرضها را ببیند، ممکن است همان خطا را تأیید کند. استقلال مفید، استقلال منبع مدرک یا روش بررسی است: پرسوجوی مستقیم از پایگاه داده، اجرای تست، کنترل محدودیتها، مقایسهٔ مجموعهٔ کلیدها و خواندن رسید از مرجع خارجی.
پژوهش Huang و همکاران دربارهٔ خوداصلاحیِ ذاتی، در وظایف استدلالی بررسیشده نشان میدهد که درخواست بازبینی بدون بازخورد خارجی میتواند ناکارآمد باشد و حتی عملکرد را کاهش دهد. این نتیجه دربارهٔ تنظیمات و مدلهای همان پژوهش است؛ نه قضیهای که همهٔ شکلهای self-correction را ناممکن بداند. درس طراحی آن، نیاز به تفکیک «دوباره فکرکردن» از «دریافت شاهد تازه» است.[۲]
برای یک verifier دودویی، نرخ خطای پنهانشده برابر حاصلضرب احتمال نتیجهٔ غلط در احتمال پذیرش مشروط به غلطبودن آن است. دقت کلی verifier جای کمیت دوم را نمیگیرد. اگر ۵٪ خروجیها غلط باشند و verifier ده درصد همان غلطها را بپذیرد، نیم درصد کل خروجیها با تأیید کاذب عبور میکنند. اگر انواع خطا عوض شوند، آن ده درصد هم ممکن است دیگر معتبر نباشد.
بررسیگر باید حق ردکردن پایان را داشته باشد، اما نباید بتواند با ساختن خروجی مطلوب خودش تقلب کند. در مهاجرت، آزمون فقط شمارش ردیفها نیست: دادهٔ تکراری یا تبدیل غلط میتواند شمارش را حفظ کند. یک بررسی ساختاری، یک بررسی معنایی روی نمونههای هدفمند و کنترل تغییرهای همزمان، پوشش متفاوتی دارند. هزینهٔ verifier را باید با ارزش کشف خطا مقایسه کرد، نه اینکه آن را همیشه یک تماس ارزان دیگر با مدل فرض کنیم.
۷. حافظهٔ عامل باید دفتر شواهد باشد، نه فقط خلاصهٔ گفتگو
در یک وظیفهٔ طولانی، تاریخچهٔ کامل برای هر تصمیم هم پرهزینه است و هم تضمین نمیکند مدل گزارهٔ مهم را حفظ کند. یک خلاصه نیز میتواند قید حیاتی را حذف کند. راه پیشنهادی، نگهداشتن وضعیت ساختاریافته کنار متن است: هدف پذیرفتهشده، محدودیتها، فرضهای باز، شواهد، قصدهای اثرگذار و شرایط پایان.
- مشاهدهٔ دارای منشأ
- پیشنهاد تصمیم
- اجرای کنترلشده
- بررسی پسشرط
هر شاهد باید منبع، زمان مشاهده، نسخهٔ منبع و گزارهای را که پشتیبانی میکند داشته باشد. «جدول منتقل شد» خیلی مبهم است؛ «در snapshot مشخص، مجموعهٔ کلیدهای مقصد با مبدا برابر بود» امکان ابطال دارد. بعد از تغییر منبع، این شاهد ممکن است منقضی شود. وضعیت معتبر باید بتواند این انقضا را بازتاب دهد.
ReAct، در پژوهش اصلی، استدلال متنی و اقدام را در یک مسیر تعاملی ترکیب میکند. این الگو برای توضیح حلقهٔ مشاهده و اقدام مفید است؛ اما خودِ وجود حلقه، صحت ابزار، استقلال راستیآزمایی یا مجازبودن اثر را اثبات نمیکند.[۳]
یک checkpoint خوب فقط ذخیرهٔ آخرین پیام نیست. باید بتوان از روی آن فهمید کدام عملیات اجرا شده، کدام نتیجه نامعلوم است و کدام فرض هنوز باز است. بعد از restart، ادامهدادن از روایت «همهچیز خوب پیش رفت» خطرناکتر از توقف صریح است.
۸. عامل چه وقت باید متوقف شود؟
توقف، پایان بودجه نیست؛ یک تصمیم است. برای بیان آن، یک مدل تصمیمگیری محدود میسازیم. b باور فعلی دربارهٔ وضعیت جهان و B بودجهٔ باقیمانده است. سه گزینه داریم: اعلام پایان، ارجاع به انسان، یا اقدام بعدی. تابع ارزشِ پیشنهادی چنین شکلی دارد:
V(b, B) = max {
  U_finish(b),
  U_escalate(b),
  maxₐ [ -c(a) + Eₒ V(b', B - c(a)) ]
}
فقط اقدامهای دارای اختیار و هزینهٔ قابلپرداخت در مجموعهٔ گزینهها قرار میگیرند. سود پایان باید زیان پایان کاذب را هم حساب کند. اگر مدرک کافی نداریم و هزینهٔ یک پرسوجوی تازه از زیان موردانتظار اعلام غلط کمتر است، بررسی بیشتر میارزد. اگر ابزار تازه اطلاعاتی اضافه نمیکند، ادامهٔ حلقه صرفاً فعالیت است، نه پیشرفت.
در سیستم واقعی معمولاً مدل احتمالی کامل نداریم. میتوان نسخهٔ قابلاجراتری ساخت: پایان فقط وقتی مجاز است که همهٔ پسشرطها شاهد معتبر داشته باشند، نتیجهٔ نامعلومِ اثرگذار باقی نمانده باشد و تخلفی از محدودیتها گزارش نشده باشد. ارجاع وقتی فعال شود که ابهام اختیار، چند شکست همنوع یا فقدان ابزار بررسی مستقل وجود دارد. سقف تلاش، زمان و هزینه نیز باید پیش از اجرا تعریف شود.
در این نگاه، سؤالپرسیدن از کاربر یک شکستِ تحقیرآمیز نیست. اگر یک پاسخ کوتاه بتواند ابهام هدف یا مجوز را رفع کند، از چندین تلاش مبهم با احتمال اثر نامناسب ارزشمندتر است. البته ارجاع بیش از حد هم هزینه دارد؛ باید نرخ ارجاع درست و ارجاع غیرضروری را جدا اندازه گرفت.
۹. ارزیابی باید پایان کاذب و مسیر خطرناک را ببیند
یک ارزیابی مناسب برای عامل طولانی، فقط فهرست وظایف نیست. شرایط آغاز، نسخهٔ ابزار، محدودیت زمان و هزینه، قرارداد موفقیت، تعداد اجراها و روش تشخیص تخلف باید ثبت شوند. توزیع وظایف مهم است: ده نسخهٔ نزدیک از یک کار آسان، شاهد توانایی عمومی روی ده نوع کار نیست.
METR در پژوهش «اندازهگیری توانایی AI برای انجام کارهای طولانی» افق زمانی را با مدت معمول انجام وظیفه توسط انسان و یک سطح احتمال موفقیت تعریف میکند. این مدت، نه زمان اجرای خود مدل است و نه تعداد فراخوانی ابزار. بنابراین نمیتوان افق زمانی انسانی یک benchmark را مستقیماً در فرمول pⁿ قرار داد. محدودیت تعمیم به وظایف واقعی هم در پژوهش مطرح شده است.[۴]
برای گزارش داخلی، چهار نرخ را پیشنهاد میکنم: موفقیت تأییدشدهٔ وظیفه، پایان کاذب، تخلف مسیر، و توقف ایمنِ بدون تکمیل. کنار آنها هزینه، تأخیر، تعداد بازیابی و تعداد آثار خارجی نامعلوم را بیاورید. افزایش موفقیت اگر با افزایش تخلف خریداری شده باشد، بهبود بیقیدوشرط نیست.
صفر خطا در یک نمونهٔ کوچک هم تضمین نیست. در مدل سادهٔ اجراهای مستقل با احتمال خطای ثابت q، احتمال ندیدن خطا در N اجرا برابر (1 − q)ᴺ است. اگر در ۱۰۰ اجرا هیچ خطایی نبینیم، حد بالای یکطرفهٔ ۹۵٪ برای q از رابطهٔ زیر حدود ۲٫۹۵٪ میشود:
(1 - q)^N = 0.05
q_upper = 1 - 0.05^(1/N)
N = 100  →  q_upper ≈ 0.02951
این استنتاج تنها زیر فرضهای همان مدل معتبر است؛ صد اجرای همبسته روی یک ورودی، تنوع صد موقعیت مستقل را نمیسازد. در عمل نتایج را بر حسب خانوادهٔ وظیفه تحلیل کنید و برای برآورد عدمقطعیت، واحد نمونهگیری را متناسب با واحد استقلال انتخاب کنید. دقت اعشار زیاد، کمبود تنوع آزمایش را جبران نمیکند.
۱۰. مثال کامل: عامل مهاجرت داده
فرض کنیم عامل باید جدول مشتریان را به ساختار تازه منتقل کند. مرحلهٔ فهم شامل شناسایی کلیدها، قواعد تبدیل و تغییرهای همزمان است. خروجی این مرحله یک قرارداد نسخهدار است، نه اجرای مستقیم. انسان یا سیاست ازپیشتعریفشده باید دامنهٔ مجاز و برنامهٔ cutover را تأیید کند.
در مرحلهٔ آمادهسازی، عامل روی snapshot یا محیط آزمون پیشنهاد تبدیل میدهد. بررسیگر مستقل، یکتایی کلید، شمارش، نمونههای مرزی و قواعد معنایی را کنترل میکند. نمونهٔ مرزی را از خود مدلِ تولیدکننده نگیریم و همان را تنها تست نکنیم؛ nullها، نویسههای غیرلاتین، کلید تکراری و تغییر حین خواندن باید از قرارداد مسئله استخراج شوند.
در مرحلهٔ اجرا، هر batch شناسه و رسید پایدار دارد. بعد از timeout، وضعیت batch استعلام میشود؛ نوشتن کورکورانه تکرار نمیشود. checkpoint شامل snapshot، cursor و batchهای تأییدشده است. اگر نسخهٔ قرارداد عوض شود، ادامهٔ خودکار با برنامهٔ قبلی متوقف میشود.
در پایان، فقط «اسکریپت exit code صفر داشت» گزارش نمیکنیم. شواهد حفظ کلیدها، سازگاری داده، رسیدگی به تغییرهای همزمان و نتیجهٔ cutover را ارائه میکنیم. اگر یکی از اینها قابلبررسی نیست، نتیجه باید «تکمیلِ تأییدنشده» یا «نیازمند تطبیق» باشد، نه موفقیت قطعی.
آیا مدل قویتر مسئله را حل میکند؟
میتواند برخی احتمالهای خطا را کاهش دهد، ولی قرارداد مبهم، اثر تکراری و verifier ضعیف را از تعریف سیستم حذف نمیکند. باید سهم بهبود مدل را جدا از سهم بهبود ابزار، بازیابی و سنجش آزمایش کنیم.
آیا چند agent همیشه قابلاعتمادترند؟
نه. تعدد میتواند بازبینی و تخصص ایجاد کند، اما فرض غلط مشترک، انتقال ناقص زمینه و اختلاف نسخهٔ هدف نیز میسازد. معیار، تعداد نقشها نیست؛ این است که آیا مدرک تازه و مسئولیت روشن اضافه شده است.
قابلیت اعتماد عامل، حاصل کیفیت یک مدل تنها نیست. قرارداد قابلبررسی، مشاهدهٔ معتبر، محدودیت اختیار، بازیابیِ دارای مدرک و تصمیم توقف، اجزای یک سیستماند. هرکدام را که به «مدل خودش میفهمد» بسپاریم، بخشی از تعهد مهندسی را به یک حدس زبانی تبدیل کردهایم.
مطالعهٔ مرتبط