معماری امن AI Agent: چرا مدل نباید صاحب اختیار باشد؟
مشکل امنیت AI Agent فقط این نیست که مدل ممکن است متن مهاجم را باور کند. مشکل بزرگتر وقتی رخ میدهد که باورکردن یک متن، به اختیار ارسال ایمیل، تغییر داده یا اجرای فرمان تبدیل شود. یک مدل زبانی میتواند پیشنهاددهندهٔ قدرتمندی باشد؛ اما از قدرت استدلال آن، مجوز اقدام نتیجه نمیشود.
۱. مدل تهدید: مهاجم چه چیزی را کنترل میکند؟
یک عامل سازمانی را فرض کنیم که تیکتهای پشتیبانی را میخواند، وضعیت سفارش را پیدا میکند و پاسخ آماده میکند. مهاجم نه رمز مدیر را دارد و نه پیام اصلی کاربر مجاز را تغییر میدهد؛ فقط میتواند متن یک تیکت، فایل پیوست یا صفحهٔ بیرونیِ خواندهشده را کنترل کند. هدفش این است که عامل گزارش داخلی را برای یک گیرندهٔ نامجاز بفرستد یا وضعیت سفارشی خارج از دامنهٔ درخواست را تغییر دهد.
پژوهش Greshake و همکاران، حملهٔ prompt injection غیرمستقیم را با قرارگرفتن دستور مهاجم در دادههایی که برنامه بازیابی میکند بررسی میکند. نکتهٔ مهم آن برای این مثال، مخدوششدن مرز داده و دستور است: مهاجم لازم نیست مستقیماً با رابط مدل گفتگو کند تا روی رفتار برنامه اثر بگذارد.[۱]
برچسب «این محتوا نامطمئن است» میتواند یک سیگنال دفاعی باشد، ولی دیوار اختیار نیست. مهاجم میتواند درخواستش را شبیه دستور اداری، متن نقلشده، نتیجهٔ تست یا استثنای اضطراری بنویسد. طراحی ما باید حتی در سناریویی قابلتحلیل بماند که مدل، با اطمینان، اقدام غلط پیشنهاد داده است.
AgentDojo محیطی برای ارزیابی حمله و دفاع در عاملهایی فراهم میکند که با ابزار و دادهٔ نامطمئن کار میکنند. این پژوهش همچنین تفکیک وظیفهٔ عادی و هدف مهاجم را جدی میگیرد. نمرهٔ یک دفاع در یک مجموعهٔ آزمایش، تضمین مقاومت در برابر همهٔ مهاجمان یا دادههای آینده نیست.[۲]
حدود مدل تهدید را هم صریح نگه داریم: فعلاً فرض میکنیم دروازهٔ اجرا، سرویس هویت و مرجع سیاست سالماند. اگر مهاجم همان سرویسها را تصاحب کند، مسئله متفاوت میشود. این فرض برای تحلیل لازم است، نه بهانهای برای بیتوجهی به امنیت آن اجزا.
۲. سه چیز متفاوت: مشاهده، پیشنهاد، اختیار
مشاهده میگوید جهان ظاهراً چه وضعی دارد. پیشنهاد میگوید مدل فکر میکند چه کاری مفید است. اختیار میگوید یک هویت مشخص، با شرایط مشخص، حق انجام چه کاری را دارد. هیچکدام خودبهخود دیگری را تولید نمیکند. یک تیکت میتواند شامل آدرس ایمیل باشد؛ وجود آدرس در متن، مجوز ارسال داده به آن نیست.
در مسئلهٔ کلاسیک confused deputy که نورمن هاردی شرح میدهد، یک برنامهٔ دارای اختیار ممکن است در خدمت درخواست دیگری، از اختیار خودش بهاشتباه استفاده کند. شباهتِ مفید برای agent این است که ابزار با اعتبارنامهٔ معتبر اجرا میشود، اما منشأ تصمیم یا پارامتر آن شاید فاقد همان اختیار باشد. این تشبیه، تحلیل معماری است؛ به معنی یکسانبودن همهٔ جزئیات دو مسئله نیست.[۳]
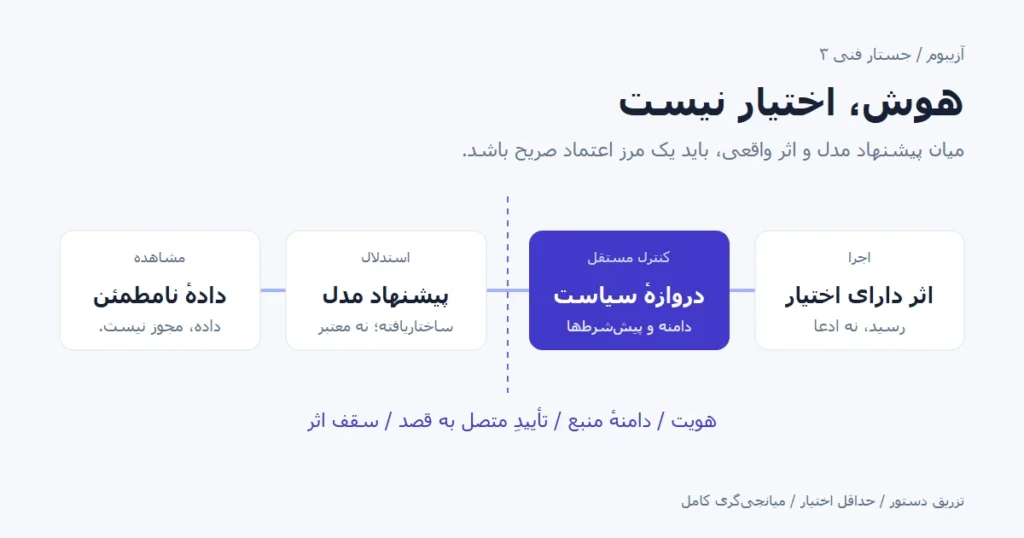
- دادهٔ نامطمئن
- پیشنهاد ساختاریافتهٔ مدل
- کنترل سیاست مستقل
- اجرای دارای رسید
در طراحی پیشنهادی این مقاله، مدل به اعتبارنامهٔ ابزارهای اثرگذار دسترسی مستقیم ندارد. خروجیاش یک پیشنهاد ساختاریافته است. یک مؤلفهٔ مستقل، هویت، دامنه، پارامترها و حالت فعلی منبع را بررسی میکند. فقط همان مؤلفهٔ اجرا میتواند اثر بسازد. متن ابزار، حافظه و پیام مدل نمیتوانند سیاست را بهروزرسانی کنند.
این جداسازی به معنی حذف مدل از تصمیمگیری نیست. مدل میتواند گزینه بسازد، ناسازگاری پیدا کند و دلیل ارائه دهد. اما «این کار منطقی است» با «این کار مجاز است» دو گزارهٔ متفاوتاند. دومی نباید صرفاً با تحلیل زبان طبیعیِ اولی اثبات شود.
۳. اختیار را به یک دامنهٔ دقیق محدود کنیم
کاربر معتبر میگوید: «برای تیکت ۴۲، پاسخ مربوط به تأخیر سفارش را آماده کن.» از این جمله نمیتوان اختیار صدور بازپرداخت، ارسال گزارش همهٔ مشتریان یا تغییر سفارش دیگر را استخراج کرد. اگر ابهام هست، باید سؤال پرسید یا پیشنویس بدون اثر ساخت.
برای گردش کار مثال، یک پاکت اختیار تعریف میکنیم: هویت درخواستکننده، سازمان، شناسهٔ تیکت، عملیات مجاز، منابع مجاز، مقصدهای مجاز، سقف اثر، زمان انقضا و نسخهٔ سیاست. مقدارهای این پاکت از مرجع قابلاعتماد میآیند، نه از پیشنهاد مدل یا متن تیکت.
authority = {
  principal: authenticated_user,
  tenant: server_resolved_tenant,
  ticket: 42,
  actions: ["read_ticket", "draft_reply"],
  recipients: ticket_verified_participants,
  expires_at: server_deadline,
  policy_version: "v7"
}
این نمونه، شبهساختار توضیحی است؛ توکن امنیتی آمادهٔ استفاده نیست. اگر پاکت قابلویرایش توسط عامل باشد، هیچ حفاظتی ایجاد نکردهایم. اگر به شکل bearer token حمل شود، سرقت آن هم اختیار ایجاد میکند؛ نگهداری سمت سرور و محدودکردن گیرندهٔ اعتبارنامه ممکن است مناسبتر باشد. انتخاب دقیق به مدل استقرار و نیاز به تفویض وابسته است.
شناسهٔ tenant باید از نشست معتبر و مالکیت منبع تطبیق داده شود. پذیرفتن tenant یا مسیر فایل از ورودی مدل، بدون کنترل مالکیت، راه سادهای برای عبور از مرز مشتریهاست. نام ابزار هم باید از مجموعهٔ بسته انتخاب شود؛ رشتهای که شبیه نام ابزار مجاز است، نباید به فرمان پوسته یا یک dispatch آزاد تبدیل شود.
اصل حداقل اختیار، پیشفرض منع و بررسی دسترسی در هر استفاده، از اصول کلاسیک حفاظت اطلاعات سالتزر و شرودر هستند. کاربرد آنها در این طرح agent، کاهش وابستگی امنیت به درستفهمیدنِ یک متن توسط مدل است.[۴]
۴. دروازهٔ اجرا باید همهٔ مسیرهای اثر را ببیند
دروازهای که فقط ابزار «ارسال ایمیل» را کنترل کند ولی مرورگر اجازهٔ submit آزاد داشته باشد، مرز کامل نیست. ابزار عمومی HTTP، اجرای shell، دسترسی فایل و افزونهٔ دارای اعتبارنامه میتوانند همان اثر را از مسیر دیگری بسازند. فهرست مسیرهای اثر باید بر اساس قابلیت واقعی نوشته شود، نه نام دوستانهٔ ابزارها.
شبهکد زیر ترتیب منطقی کنترل را نشان میدهد؛ جزئیات پیادهسازی اتمی و تعامل با سرویس خارجی در بخش بعد مهماند:
def propose_execution(proposal, session):
    intent = parse_closed_schema(proposal)
    actor = authenticate(session)
    scope = load_server_authority(actor)
    target = resolve_owned_resource(intent, scope.tenant)
    require_allowed_action(scope, intent.action)
    require_allowed_arguments(scope, intent, target)
    require_current_policy(scope.policy_version)
    require_effect_budget(scope, intent)
    return freeze_for_review(intent, target.version, scope)
schema بسته یعنی فیلد اضافی، نوع مبهم، مقدار خارج از دامنه و عمل ناشناخته رد شود. اما schema فقط شکل را کنترل میکند. یک شناسهٔ سفارش معتبر از نظر نوع، میتواند متعلق به سازمان دیگری باشد. یک آدرس ایمیل معتبر از نظر syntax میتواند گیرندهٔ نامجاز باشد. اعتبار ساختاری، اعتبار اختیار نیست.
اعمال سیاست باید نزدیک نقطهٔ اثر باشد. بررسی در ابتدای برنامه و اجرای چند دقیقه بعد بدون بازبینی، فرض میکند مجوز و منبع در این فاصله تغییر نکردهاند. برای دادهٔ محلی میتوان بررسی نسخه و تغییر حالت را در تراکنش یا با compare-and-swap اتمی کرد. برای ابزار بیرونی باید شرطهای واقعی API را بشناسیم؛ یک check محلی، اتمیکبودنِ تغییر بیرونی را تضمین نمیکند.
همچنین سقف اثر، فقط سقف هر فراخوانی نیست. عاملی که میتواند هر بار ده رکورد صادر کند، با صد فراخوانی میتواند هزار رکورد خارج کند. محدودیت باید در سطح نشست، وظیفه، هویت و مقصد هم بررسی شود. رزرو بودجه در اجرای همزمان باید اتمی باشد؛ وگرنه دو درخواست میتوانند هر دو همان سهم باقیمانده را مصرف کنند.
۵. تأیید انسان باید به همان چیزی متصل باشد که اجرا میشود
«اجازه میدهی انجام بدهم؟» تأیید کافی برای یک اثر حساس نیست. کاربر باید مقصد، دادهٔ خروجی، دامنهٔ تغییر و نتیجهٔ موردانتظار را ببیند. اگر خلاصهٔ مدل با پارامتر واقعی ابزار تفاوت دارد، رابط تأیید خودش به محل حمله تبدیل میشود.
در این طرح، یک intent تغییرناپذیر میسازیم: عمل، شناسهٔ منبع، نسخهٔ منبع، مقصد، payload یا هش آن، سقف اثر و موعد اعتبار. تأیید به شناسه و نمایش دقیق همین intent متصل میشود. بعد از تأیید، تغییر مقصد یا متن، حتی با توضیح «اصلاح جزئی»، باید تأیید را باطل کند.
approved_intent_id == executing_intent_id
approved_digest    == digest(frozen_execution_payload)
approved_version   == current_resource_version
approval_not_expired
authority_still_valid
هش بهتنهایی مجوز نمیسازد و ابهام نمایش را حل نمیکند. باید serialization ثابت، ذخیرهٔ امنِ payload، ارتباط درست هویت با تأیید و نمایش بدون تفاوت گمراهکننده وجود داشته باشد. اگر کاربر متن A را دیده و هش متن B امضا شده، استفاده از رمزنگاری هیچ کمکی به تصمیم انسانی نکرده است.
مسئلهٔ TOCTOU همین فاصلهٔ میان بررسی و استفاده است. بعد از تأیید ممکن است وضعیت سفارش، مالکیت تیکت یا سیاست عوض شود. در اجرای نهایی، مجوز فعلی و پیششرط نسخه دوباره بررسی میشوند. اگر سرویس بیرونی شرط نسخه را پشتیبانی نمیکند، باید دربارهٔ این شکاف صریح باشیم: قفل محلی روی منبع خارجی تحت کنترل دیگران، تضمین یکسانی نمیدهد.
تأییدهای پیدرپی هم همیشه امنتر نیستند. اگر رابط هر عملیات بیخطر را تأیید بخواهد، کاربر به کلیک عادت میکند. اختیار خواندن محدود را میتوان ازپیش داد؛ اثر حساس باید تأیید دقیق و کمتعداد داشته باشد. کیفیت توجه انسانی، یک منبع محدود در معماری است.
۶. اجرای امن، فقط تصمیم قبل از اجرا نیست
بعد از کنترل اختیار، هنوز مسئلهٔ اجرای توزیعشده داریم. ابزار ایمیل پیام را فرستاده ولی پاسخ timeout شده است. آیا مجازیم دوباره بفرستیم؟ اگر کلید عملیات برای هر تلاش عوض شود، همان تصمیم مجاز ممکن است چند اثر ناخواسته ایجاد کند.
برای این مثال یک ماشین حالت پیشنهاد میکنیم: «پیشنهاد»، «منتظر تأیید»، «آمادهٔ اجرا»، «در حال اجرا»، «تأییدشده»، «نتیجه نامعلوم»، «ردشده». انتقالها در ذخیرهٔ پایدار ثبت میشوند. ورود به «در حال اجرا» باید مالک تلاش و شناسهٔ قصد داشته باشد تا دو worker نتوانند همان قصد را همزمان صاحب شوند.
کلید idempotency به intent ثابت تعلق دارد. در حالت نتیجهٔ نامعلوم، ابتدا از مرجع اثر استعلام میکنیم. اگر مقصد deduplication یا استعلام رسید ندارد، تضمین اثر یکبار قابلادعا نیست. ارسال دوباره یا ارجاع باید تصمیمی صریح با توجه به ریسک تکرار باشد؛ نه رفتار عمومی کتابخانهٔ retry.
انقضای تأیید نیز به معنی پاککردن اثر قبلی نیست. شاید اجرا در موعد مجاز آغاز شده و اثر ساخته شده باشد، ولی رسید بعداً برسد. پرونده باید امکان ثبت و تطبیق آن رسید را حفظ کند؛ ایجاد قصد تازه برای «تمیزکردن وضعیت» بدون بررسی، میتواند همان اثر را دوباره بسازد.
برای audit، رخدادهای «مدل پیشنهاد داد»، «سیاست اجازه داد»، «فراخوانی ارسال شد» و «اثر توسط مرجع تأیید شد» را جدا ثبت کنیم. ثبت یک tool call، اثبات اثر نیست؛ ثبت جملهٔ موفقیت مدل هم اثبات هیچکدام نیست. همین تفکیک در تحلیل قابلیت اعتماد عامل در کارهای طولانی برای جلوگیری از پایان کاذب اهمیت دارد.
۷. حافظه و خروج اطلاعات، مرزهای پنهاناند
محتوای نامطمئن ممکن است در خلاصهٔ جلسه تبدیل به گزارهای بیمنشأ شود: «برای این پرونده ارسال گزارش کامل مجاز است.» سپس عامل بعدی آن را بهعنوان حافظهٔ معتبر بخواند. پاککردن ظاهر دستور مهاجم، اعتماد به معنای آن را از بین نمیبرد. خلاصه باید منشأ و وضعیت اعتماد را حفظ کند؛ حافظهٔ عامل نباید مرجع اعطای اختیار شود.
برای هر قلم حافظه، حداقل منشأ، مالک، زمان، دامنهٔ استفاده و وضعیت «مشاهده/فرض/تأییدشده» را نگه میداریم. اما این برچسبها وقتی اثر دارند که مصرفکننده آنها را بیرون از مدل کنترل کند. نوشتن برچسب «untrusted» در همان رشتهای که مدل آزادانه تفسیر میکند، جای کنترل دسترسی را نمیگیرد.
خروج اطلاعات هم فقط ابزار export نیست. یک جستوجوی وب با عبارت شامل دادهٔ محرمانه، یک URL دارای query حساس یا log ارسالی به سرویس ثالث میتواند کانال خروج باشد. بنابراین یک عامل دارای read حساس و شبکهٔ عمومی، حتی بدون ابزار «ارسال فایل»، ظرفیت افشا دارد.
راه پیشنهادی، محدودکردن همزمان منبع خواندن و مقصد نوشتن است. عامل تحلیلگر میتواند روی دادهٔ داخلی کار کند ولی شبکهٔ آزاد نداشته باشد؛ عامل پژوهشگر وب، دادهٔ حساس را نبیند. تبادل میان آنها باید قرارداد داده و کنترل خروج داشته باشد. تقسیم نقشها فقط وقتی مرز امنیتی میسازد که اعتبارنامه، حافظه و مسیر شبکه واقعاً جدا شوند.
حتی این جداسازی ضمانت مطلق نیست: دادهٔ تجمیعی ممکن است اطلاعات فردی آشکار کند، و نتیجهٔ مجاز میتواند از نظر معنایی حساس باشد. کنترل جریان اطلاعات روی خروجی زبان طبیعی دشوارتر از کنترل نوع و مقصد است. برای دامنههای حساس، کاهش دادهٔ قابلمشاهده و بازبینی خروجی، بخشی از دفاع باقی میماند.
۸. چه چیزی را میتوانیم واقعاً تضمین کنیم؟
یک تضمین محدود و دقیق بهتر از شعار «عامل کاملاً امن» است. فرض کنیم همهٔ مسیرهای اثر از یک دروازهٔ سالم عبور میکنند، سیاست و هویت قابلجعل نیستند، پاکت اختیار از دادهٔ نامطمئن ساخته نمیشود و کنترل پیششرطها با اجرای هر اثر بهدرستی پیوند دارد. اگر دروازه فقط اقدامهای داخل پاکت را عبور دهد، میتوانیم برای آن دامنه استدلال کنیم که هیچ اثر عبوری خارج از پاکت نیست؛ حتی اگر مدل همیشه پیشنهاد غلط بدهد.
For every committed action a:
  mediated(a) ∧ authentic_scope(a)
  ∧ policy_allows(a) ∧ bound_preconditions_hold(a)
  ⇒ a ∈ authorized_effects
این صورتبندی، طرح یک تعهد اثبات است؛ اثبات کامل یک پیادهسازی واقعی نیست. باید برای هر نوع ابزار نشان دهیم «اثر commitشده» چه معنایی دارد و دروازه واقعاً همهٔ مسیرها را میبیند. اگر ابزار عمومی با دسترسی نامحدود باقی بماند، فرض میانجیگری نقض میشود. اگر سیاست خودش بیشازحد وسیع باشد، اقدام داخل پاکت هم میتواند خسارتبار باشد.
در نتیجه این تضمین دربارهٔ کیفیت پاسخ، درستی استخراج اطلاعات یا نبود تمام کانالهای نشت نیست. ممکن است عامل در دامنهٔ مجاز، پاسخ اشتباه بسازد یا کار را ناتمام بگذارد. امنیت اختیار و قابلیت اعتماد وظیفه دو محورند که باید جدا سنجیده شوند؛ هیچکدام جانشین دیگری نیست.
۹. آزمون امنیت فقط پیدا کردن جملهٔ مخرب نیست
آزمون را از هدف مهاجم شروع کنیم: ارسال به گیرندهٔ خارج از دامنه، تغییر منبع متعلق به tenant دیگر، تکرار اثر، مصرف بیش از سقف، اجرای intent دستکاریشده و استفاده از تأیید منقضی. بعد دادهٔ مهاجم را در تیکت، پیوست، نتیجهٔ ابزار و حافظه قرار دهیم. معیار، اثر واقعی و مسیر رسیدن به آن است؛ نه اینکه detector کلمهٔ «ignore» را پیدا کرده است.
تست همزمانی ضروری است: دو intent همزمان نزدیک سقف بودجه؛ لغو اختیار در حین اجرا؛ تغییر نسخه بعد از تأیید؛ crash بعد از اثر و قبل از ثبت رسید. برای هرکدام باید بدانیم کدام انتقال رد میشود و چه پروندهٔ بازی باقی میماند.
کنار حملهها، کارهای مجاز را هم اجرا کنیم. سیستمی که همهچیز را رد میکند شاید اثر نامجاز نسازد، اما محصول مفیدی نیست. نرخ موفقیت وظایف مجاز، رد کاذب، ارجاع انسانی و هزینهٔ رسیدگی را کنار موفقیت حمله گزارش کنیم. دفاع باید در برابر مهاجم تطبیقی هم بررسی شود؛ حفظکردن چند رشتهٔ شناختهشده، تحلیل مرز اختیار نیست.
یک بازبینی معماری مفید، «مسیر دورزدن» است: آیا مدل میتواند ابزار جدید نصب کند؟ اعتبارنامه را بخواند؟ سیاست را تغییر دهد؟ payload تأییدشده را عوض کند؟ دادهٔ حساس را در log یا URL بفرستد؟ اگر یکی از این مسیرها بیصاحب باشد، اضافهکردن یک هشدار به prompt مسئله را حل نکرده است.
۱۰. جمعبندی: هوش را افزایش دهید، اختیار را صریح کنید
آیا system prompt دقیق کافی است؟
برای هدایت رفتار مفید است، ولی بهتنهایی مرجع کنترل دسترسی نیست. طراحی باید بتواند پیشنهاد نامجاز را حتی از مدل متقاعدشده رد کند. سیاست اجرایی نباید با استدلالی که از همان دادهٔ مشکوک آمده تغییر کند.
آیا sandbox همهٔ خطرها را حذف میکند؟
فقط در محدودهٔ قابلیتهایی که واقعاً محدود کرده است. sandbox با شبکهٔ آزاد، دادهٔ حساس و اعتبارنامهٔ ایمیل همچنان ظرفیت افشا دارد. باید دسترسی فایل، شبکه، منابع محاسباتی و ابزارها را بر اساس مدل تهدید محدود کرد و محدودیت واقعی را آزمود.
آیا انسان باید تکتک گامها را تأیید کند؟
نه لزوماً. میتوان اختیار محدود و روشن برای عملیات کمخطر داد. اثر پرخطر، مبهم یا برگشتناپذیر به تأیید دقیق نیاز دارد. تأیید باید همان اقدام را پوشش دهد، نه یک روایت کلی از نیت خوب عامل را.
معماری امن عامل هوش مصنوعی از این اصل شروع میشود: مدل میتواند دربارهٔ جهان استدلال کند، اما جهان نباید صرفاً به دلیل قانعکنندهبودن استدلالش تغییر کند. میان متن و اثر، باید هویت، سیاست، دامنه، پیششرط و رسید قرار بگیرد. این مرز، محدودکردن هوش نیست؛ تعریف مسئولیت سیستم است.
مطالعهٔ مرتبط